Tout comprendre sur le pattern CQRS : architecture, avantages et implémentation
Le pattern CQRS sépare les opérations de lecture des écritures en deux modèles distincts.
- Commandes pour modifier l’état, requêtes pour lire.
- Optimisation de chaque côté, performance et scalabilité.
- Hérité du principe CQS de Bertrand Meyer.
- Élevé à l’échelle architecturale par Greg Young.
- Réduit les latences de 600 ms à 6 secondes.
- Permet des vues pré-calculées en cache.
Qu’est-ce que le pattern CQRS ? Définition et principes fondamentaux
Le pattern CQRS (Command Query Responsibility Segregation) repose sur une idée simple : séparer les opérations de lecture des opérations d’écriture. Dans une architecture classique, un même modèle de données sert à la fois à consulter l’information et à la modifier, à la manière des différences GraphQL REST. CQRS casse cette logique en créant deux modèles distincts : un modèle d’écriture (les Command) qui modifie l’état, et un modèle de lecture (les Query) qui renvoie des données sans effet de bord.
Cette séparation permet d’optimiser chaque côté indépendamment, que ce soit en termes de performance, de scalabilité ou de maintenabilité. Concrètement, vous pouvez choisir une base relationnelle pour les écritures et une base de lecture dédiée pour les requêtes, sans compromis sur l’un ou l’autre.
Origine du pattern : du CQS au CQRS
Le concept ne date pas d’hier. Il puise ses racines dans le principe Command Query Separation (CQS), introduit par Bertrand Meyer dans le langage Eiffel. Meyer posait une règle fondamentale : une méthode doit être soit une commande (elle modifie l’état), soit une requête (elle retourne un résultat), mais jamais les deux à la fois.
Le passage de CQS à CQRS s’est fait naturellement : là où CQS s’applique au niveau des méthodes d’une classe, CQRS élève le principe à l’échelle de l’architecture. Les ressources de référence sur ce pattern remontent à l’année 2000, avec les travaux de Greg Young qui ont popularisé l’approche dans les communautés.NET et DDD.
Le principe de séparation des modèles de lecture et d’écriture
L’idée centrale est de traiter la lecture et l’écriture comme deux sous-applications distinctes qui partagent une base de données commune, ou parfois deux bases différentes. Le modèle d’écriture se concentre sur l’intégrité des données et les règles métier, tandis que le modèle de lecture est optimisé pour la rapidité d’affichage.
Cette séparation répond à un vrai problème : dans une infrastructure classique, les temps de réponse des API peuvent varier de 600 ms à 6 secondes selon la charge. En isolant les lectures, vous réduisez drastiquement les latences perçues par l’utilisateur final, tout en gardant un système d’écriture solide et transactionnel, tout comme une inférence avec vLLM optimise les temps de réponse. Côté lecture, vous pouvez mettre en cache des vues pré-calculées, utiliser des index dédiés ou dupliquer les données dans un format dénormalisé sans jamais impacter le processus d’écriture, une approche comparable à l’optimisation RAG.
Quels sont les avantages et les inconvénients du pattern CQRS ?
- Scalabilité indépendante : vous dimensionnez les serveurs de lecture et d’écriture séparément selon leur charge réelle.
- Réduction des conflits de fusion : les environnements collaboratifs évitent les verrous et les écrasements de données simultanés.
- Lecture sans effets de bord : les requêtes n’altèrent jamais l’état du système, ce qui élimine les surprises en production.
- Complexité de conception élevée : deux modèles à maintenir exigent une discipline d’équipe et une documentation rigoureuse.
- Coût de refactoring important : chaque modification métier implique une double mise à jour côté Query et côté Command.
Le principal gain concerne la scalabilité : un service de lecture peut monter en charge sans impacter les écritures, ce qui répond aux latences observées sur les API traditionnelles (souvent comprises entre 600 ms et 6 secondes). En isolant les chemins, vous réduisez aussi les risques de conflits de fusion dans les environnements collaboratifs et vous garantissez des opérations de lecture sans effet de bord.
Cependant, la contrepartie est réelle : la complexité de conception augmente sensiblement. Vous devez maintenir deux modèles distincts, synchroniser leurs évolutions et assumer un coût de refactoring plus lourd à chaque changement métier. Cette double maintenance se révèle souvent excessive pour des applications CRUD simples, où un modèle unique reste plus efficace et plus rapide à faire évoluer.
Quand utiliser CQRS ? Cas d’usage et contexte d’application
Le pattern CQRS s’impose dans les environnements collaboratifs où plusieurs utilisateurs manipulent simultanément les mêmes données. Les conflits de fusion et les verrous deviennent alors un frein majeur. La séparation des lectures et des écritures réduit ces frictions et offre une scalabilité indépendante aux deux flux.
C’est aussi la solution adaptée lorsque vos temps de réponse ne sont plus homogènes. Si des API accusent des latences variant de 600 ms à 6 secondes selon le type d’opération, l’optimisation séparée des chemins de lecture et d’écriture devient pertinente. Vous pouvez ainsi dimensionner chaque infrastructure selon ses besoins réels.
En revanche, pour une application CRUD simple, l’adoption de CQRS ajoute une complexité disproportionnée. Le coût de refactoring double (modèles Query et Command) et l’architecture unique reste plus efficace pour des besoins de performance modérés. Réservez ce pattern aux systèmes où la pression sur les données justifie l’investissement.
Architecture interne : Command, Query et composants clés
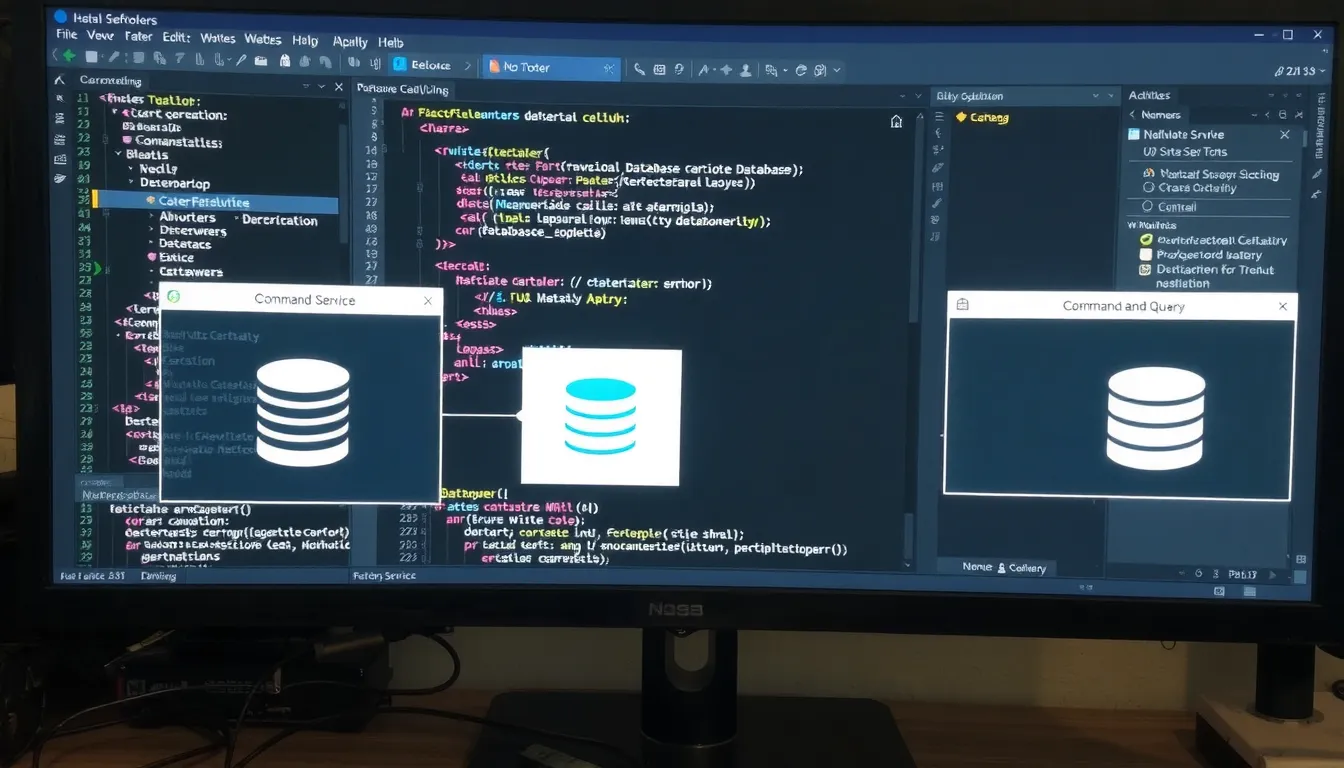
Command et CommandHandler : le côté écriture
Côté écriture, tout repose sur la Command : une intention explicite de modifier l’état du système. Par exemple, * »Ajouter un livre »* ou * »Emprunter cet ouvrage »*. La commande est un objet immuable qui transporte les données nécessaires, sans aucune logique métier.
Le CommandHandler est le composant qui reçoit cette commande et l’exécute. Il valide les règles métier, puis applique les modifications au magasin de données. Le pattern recommande un handler dédié pour chaque type de commande, ce qui garantit un traitement isolé et testable, à l’image de l’implémentation d’agents dans les architectures LLM. Les opérations d’écriture peuvent devenir complexes : des traitements non-bloquants, comme la génération de recommandations, peuvent s’exécuter en arrière-plan. Cette souplesse explique pourquoi le temps de réponse des écritures peut varier, parfois de 600 ms à 6 secondes, selon la charge et la complexité des traitements.
Query et Reading Component : le côté lecture
Du côté lecture, la Query représente une simple question posée au système : * »Quels livres sont disponibles ? »* Elle ne modifie jamais l’état. Le Reading Component (ou Query Handler) interroge directement la base de données et renvoie une représentation adaptée à l’affichage.
Cette séparation permet d’optimiser chaque côté indépendamment : le modèle de lecture peut être dénormalisé, mis en cache ou indexé différemment pour des réponses plus rapides, tandis que le modèle d’écriture reste strictement normalisé pour garantir l’intégrité des données. L’architecture peut même aller plus loin : deux services indépendants partageant une base commune, ou deux bases distinctes. Dans ce dernier cas, le service Command prépare les données que le service Query renverra, au prix d’une cohérence éventuelle.
En pratique, cette dualité simplifie la conception en répondant à des préoccupations spécifiques, mais elle exige une discipline rigoureuse : chaque opération doit clairement être étiquetée comme lecture ou écriture, sans ambiguïté possible.
Exemple d’implémentation pratique : gestion d’une bibliothèque
Pour concrétiser les concepts, rien ne vaut un exemple fil conducteur. Prenons le cas d’une application de gestion de bibliothèque. Avec une approche CRUD classique, une seule entité « Livre » sert à la fois pour l’affichage, la création et la mise à jour. L’objectif ici est de démontrer comment le pattern CQRS introduit une séparation nette des responsabilités entre ce qui modifie les données et ce qui les consulte. On conserve les opérations métier de base, mais on structure le code en deux volets distincts.
Définition des interfaces de lecture et d’écriture
La première étape consiste à définir des modèles (ou DTO) séparés pour chaque contexte. Le côté écriture (Command) possède sa propre représentation d’un livre. Du côté lecture (Query), la structure est différente et souvent optimisée pour l’affichage. Cette séparation signifie que le modèle d’écriture peut contenir des règles métier subtiles, tandis que le modèle de lecture peut regrouper des informations provenant de plusieurs sources.
Prenons un cas simple : lors d’une création, le service d’écriture (le `CommandHandler`) valide les règles de gestion. Il ne se soucie pas de savoir comment les données seront affichées. À l’inverse, le service de lecture (le `Reading Component`) a pour mission de répondre le plus rapidement possible aux demandes d’affichage. Les deux interfaces évoluent ainsi indépendamment, réduisant les conflits lors des modifications, un avantage majeur dans un environnement collaboratif.
Interaction entre les composants et la base de données
L’architecture proposée par le pattern suggère l’utilisation de deux bases de données distinctes : une pour le côté écriture, une pour le côté lecture. Pour la bibliothèque, le service Command enregistre les nouvelles entrées et les retours de prêt. Le service Query, lui, interroge un modèle dénormalisé et pré-agrégé pour compiler des listes de livres disponibles. La communication entre ces deux mondes se fait généralement par le biais d’événements ou de synchronisations périodiques.
Ce découplage résout un problème épineux : les architectures traditionnelles peinent à offrir des performances stables lorsqu’elles doivent gérer des modèles complexes en lecture comme en écriture. Il n’est pas rare d’observer des temps de réponse d’API fluctuant entre 600 ms et 6 secondes sur des modèles uniques mal optimisés. Avec CQRS, le service de lecture peut ajuster ses requêtes et ses index sans craindre de casser la logique d’écriture, rendant les temps de latence nettement plus prévisibles.
Le problème à l’origine du pattern : quand l’architecture traditionnelle limite
Pour comprendre l’intérêt du pattern CQRS, il faut d’abord observer ce qui se passe lorsqu’une application repose sur un modèle de données unique pour la lecture et l’écriture. Dans une architecture classique, le même objet (par exemple, un `Book`) sert à la fois à créer, mettre à jour et afficher les données. Ce fonctionnement, simple au démarrage, devient rapidement un frein à la performance lorsque l’application grandit.
Les symptômes sont souvent les mêmes : le volume de données augmente, les requêtes de lecture deviennent complexes, et les temps de réponse s’allongent. Dans des contextes de forte charge, des équipes ont observé des latences de 600 ms à 6 secondes sur leurs API. Cette variabilité est problématique : elle traduit un modèle d’écriture qui contamine les accès en lecture, et vice-versa.
| Limite de l’architecture unique | Symptôme observé | Conséquence applicative |
|---|---|---|
| Modèle de données unique | Requêtes entrelacées | Optimisation difficile |
| Le schéma sert les deux usages | Latences variables sur les API | Expérience utilisateur dégradée |
| Pas de scalabilité ciblée | La montée en charge sature | Infrastructure surdimensionnée |
| Jointures et calculs lourds | Lectures lentes (de 600 ms à plusieurs secondes) | Timeouts et erreurs |
Ce tableau reflète un problème structurel : le modèle unique essaie de répondre à deux préoccupations différentes avec un seul outil. C’est pour répondre à cette limitation que le pattern CQRS propose une séparation nette des chemins de lecture et d’écriture, permettant à chaque côté d’évoluer et de performer selon ses propres contraintes.
FAQ : Questions fréquentes sur le pattern CQRS
CQRS est-il adapté à une application CRUD simple ?
Non, CQRS est excessif pour un CRUD simple. Cette architecture ajoute une complexité inutile lorsque les opérations de lecture et d’écriture sont simples et symétriques. Un CRUD classique utilise un modèle unique, plus simple à maintenir et suffisant pour des besoins standards. CQRS ne démontre sa valeur que sur des systèmes aux lectures et écritures complexes ou fortement asymétriques.
Comment assurer la cohérence entre les modèles de lecture et d’écriture ?
La cohérence est garantie par le principe de cohérence éventuelle. Les commandes écrivent dans la source de vérité, puis des événements synchronisent le modèle de lecture. Cette synchronisation est généralement asynchrone via des messages ou des projections. Il existe une fenêtre de latence, mais elle est compensée par des mécanismes de mise à jour et de compensation dans la couche applicative.