Qu’est-ce que la RAG agentique ? Le guide complet pour comprendre son fonctionnement
La RAG agentique utilise des agents IA pour planifier et exécuter des recherches dynamiques.
- Agents de routage sélectionnent les sources pertinentes.
- Décomposition des requêtes complexes en sous-requêtes.
- Boucles de feedback valident les résultats avant génération.
- Le pipeline dynamique s’adapte à la complexité de la question.
Comment fonctionne la RAG agentique ?
La RAG agentique intègre des agents IA directement dans la phase de récupération du pipeline. Contrairement au flux séquentiel classique, ces agents planifient, routent et exécutent des actions dynamiques pour trouver l’information la plus pertinente. Ils peuvent décomposer une requête complexe en sous-requêtes, sélectionner les sources de connaissances appropriées et appeler des fonctions externes ou des API en temps réel, un peu comme comprendre Apache Kafka pour gérer des flux de données en temps réel.
Cette architecture repose sur des agents de routage qui choisissent les sources disponibles, et des agents ReAct capables de raisonner et d’agir en multi-étapes pour affiner la recherche, à la manière de Podman qui gère des conteneurs sans démon. Des boucles de feedback permettent de valider et améliorer les résultats avant de les transmettre au LLM pour la génération de la réponse finale, ce qui offre une adaptabilité bien supérieure à un pipeline statique, comme dans les cours sur agents IA qui montrent leur capacité d’action autonome.
RAG agentique vs RAG traditionnel
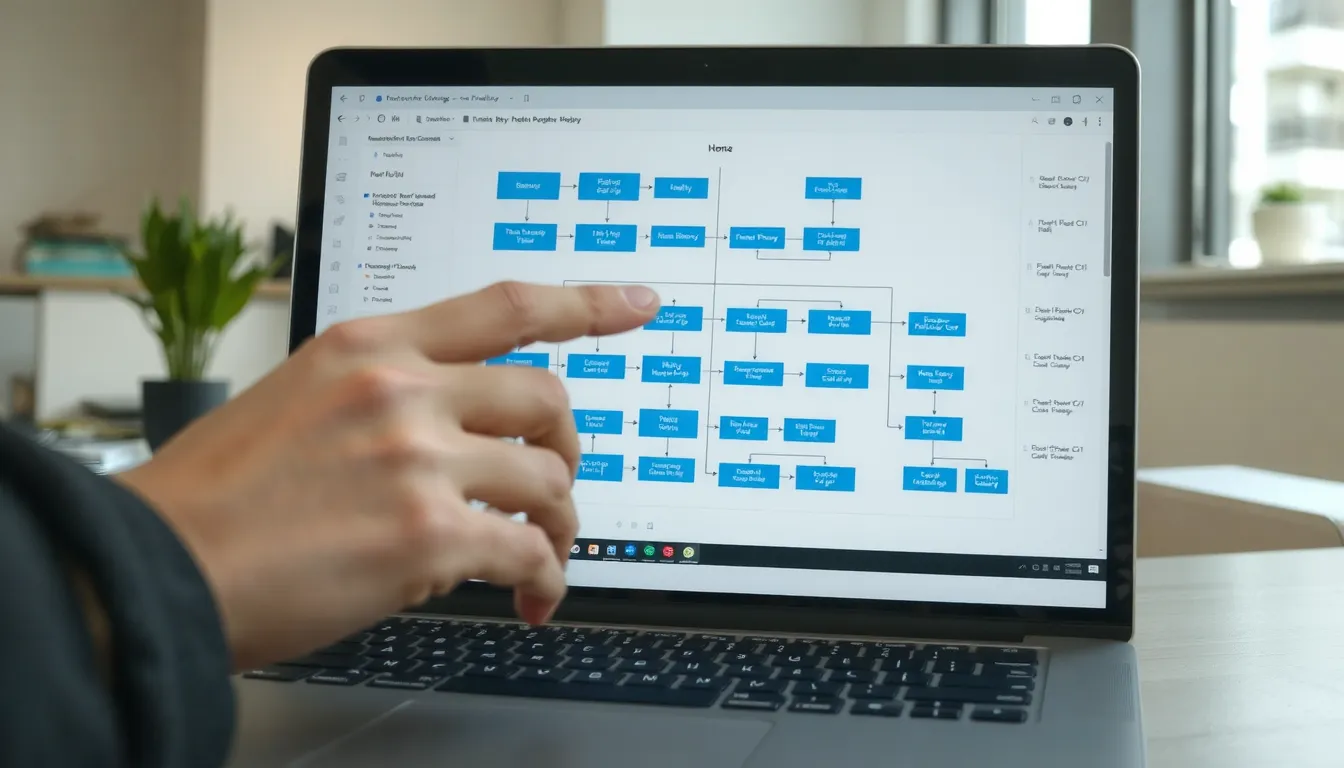
La différence fondamentale entre les deux approches tient à la nature du pipeline. La RAG traditionnelle fonctionne comme un conduit statique : une requête entre, une recherche est effectuée, un contexte est ajouté, et une réponse sort. Ce processus séquentiel ne s’adapte pas à la complexité de la question posée.
La RAG agentique, elle, introduit une boucle de décision. Au lieu d’exécuter une seule recherche générique, les agents évaluent la requête, choisissent les sources pertinentes, décomposent le problème en sous-tâches et itèrent jusqu’à obtenir un résultat satisfaisant. Cette flexibilité se paie en complexité et en coûts de calcul.
| Critère de comparaison | RAG traditionnel | RAG agentique |
|---|---|---|
| Pipeline | Séquentiel et fixe | Dynamique et piloté |
| Sources de données | Base unique et dédiée | Multi-sources et outils |
| Raisonnement | Une seule étape | Multi-étapes avec ReAct |
| Requêtes complexes | Réponse approximative | Décomposition en sous-requêtes |
| Adaptabilité | Faible, contexte fixe | Haute, validation itérative |
| Coût d’exploitation | Maîtrisé | Élevé (tokens et calcul) |
| Boucle de feedback | Absente | Intégrée et continue |
Quand privilégier chaque approche
La RAG traditionnelle reste pertinente pour les usages simples : réponse à des questions factuelles sur un corpus unique, recherche documentaire basique, ou contextes où le budget est limité. Son coût réduit et sa latence faible la rendent adaptée aux applications à fort volume.
La RAG agentique s’impose dès que la requête exige un raisonnement multi-étapes, une agrégation de plusieurs sources ou un appel à des outils externes. Les agents de routage sélectionnent les sources, tandis que les agents de planification structurent la recherche. Le résultat final bénéficie d’une validation et d’un affinage que la RAG classique ne peut offrir, au prix d’une complexité d’intégration bien supérieure.
Cas d’utilisation de la RAG agentique
La RAG agentique n’est pas un simple concept théorique. Elle répond à des besoins concrets là où la RAG classique montre ses limites : silos de données hétérogènes, requêtes complexes et besoin de résultats vérifiés. Voici les cinq cas d’usage qui illustrent le mieux sa valeur ajoutée.
- Recherche d’entreprise multi-silos : un agent unique interroge simultanément des e-mails, API internes et bases documentaires pour fournir une réponse consolidée en temps réel.
- Support client contextuel personnalisé : l’agent croise l’historique d’achat du client avec la base de connaissances produit pour générer une réponse adaptée, sans récupération générique.
- Synthèse médicale d’aide décisionnelle : le système compile des recherches cliniques récentes et des données patient pour proposer des options aux praticiens, avec traçabilité des sources.
- Tutorat intelligent à la demande : l’agent identifie les lacunes de l’apprenant, sélectionne les ressources pédagogiques pertinentes et adapte son explication en plusieurs étapes.
- Automatisation rapports et analyse KPI : les agents collectent des données de plusieurs outils analytiques, les recoupent et génèrent un rapport d’intelligence économique structuré, sans intervention humaine.
Le point commun : la boucle de feedback
Dans chacun de ces cas, l’architecture ne se contente pas d’un aller-retour requête-réponse. L’agent évalue la pertinence des informations récupérées, identifie les manques et relance une nouvelle itération de recherche si nécessaire. Cette boucle de validation garantit un niveau de précision impossible à atteindre avec un pipeline statique, à l’image des agents IA de recouvrement qui automatisent les relances clients.
Prenons l’exemple du support client : si la première recherche ne retourne qu’une documentation générale, l’agent détecte l’absence de données spécifiques au contrat du client et affine sa requête vers la base de contrats. Cette adaptation dynamique en cours de traitement est la signature de la RAG agentique.
Avantages et inconvénients de la RAG agentique
Choisir entre une RAG traditionnelle et une RAG agentique revient souvent à arbitrer entre deux priorités : la maîtrise des coûts et la simplicité d’un côté, la flexibilité et la profondeur d’analyse de l’autre. Pour vous aider à décider, voici un bilan clair des forces et des faiblesses de l’approche agentique.
Les avantages de la RAG agentique
Là où la RAG classique se contente d’une recherche unique, la RAG agentique transforme le processus en une véritable enquête. Cette architecture apporte des bénéfices concrets pour les cas d’usage exigeants.
- Récupération adaptative multi-sources : l’agent consulte dynamiquement plusieurs bases internes, API et outils pour croiser les informations.
- Boucle feedback amélioration continue : chaque réponse est analysée et réinjectée dans le système pour affiner les recherches suivantes.
- Validation affinage résultats récupérés : l’agent vérifie la pertinence des données trouvées avant de les intégrer à la réponse finale.
- Raisonnement complexe à plusieurs étapes : les requêtes sont décomposées en sous-problèmes, résolus de manière séquentielle comme le ferait un analyste.
Les inconvénients et défis
Cette puissance a un prix. La mise en œuvre d’un pipeline agentique demande une infrastructure plus robuste et une maintenance attentive, ce qui peut freiner les équipes aux ressources limitées.
- Coûts tokens et calcul élevés : chaque appel d’outil et chaque itération de raisonnement multiplient la consommation de ressources.
- Intégration complexe agents-recherche : connecter les agents aux systèmes internes existants nécessite un travail de développement et de tests approfondi.
- Risques de biais données récupérées : l’agent peut amplifier des incohérences présentes dans les sources externes sans filtrage humain suffisant.
- Latence accrue réponse utilisateur finale : le temps de réponse s’allonge sensiblement, car l’agent exécute plusieurs étapes avant de synthétiser un résultat.
Qu’est-ce que la RAG ?
La RAG (Retrieval-Augmented Generation), ou génération augmentée de récupération, est une architecture qui connecte un grand modèle de langage (LLM) à une base de connaissances externe. Son principe est simple : avant de générer une réponse, le système va chercher des informations pertinentes dans cette base pour enrichir la requête de l’utilisateur avec un contexte supplémentaire.
Ce processus se déroule selon un pipeline statique et séquentiel : une seule requête est envoyée, une récupération unique est effectuée, puis le modèle génère sa réponse. Ce mécanisme réduit considérablement les hallucinations en ancrant la génération dans des données vérifiables, tout en permettant au LLM de répondre sur des sujets qui dépassent son corpus d’entraînement initial.
La RAG classique constitue donc la fondation sur laquelle repose la RAG agentique, en apportant une première couche de fiabilité et de fraîcheur aux réponses générées par l’IA.
Définition de l’IA agentique
L’IA agentique désigne une intelligence artificielle capable de déterminer et d’exécuter un plan d’action autonome pour atteindre un objectif précis. Contrairement à un chatbot classique qui se limite à générer du texte, un agent perçoit son environnement, décide des étapes à suivre, puis agit via des appels de fonctions. Cette capacité transforme le LLM d’un simple outil conversationnel en un véritable acteur numérique.
Concrètement, l’agent s’appuie sur des modèles de langage enrichis de raisonnement multi-étapes pour orchestrer des actions : interroger une API, mettre à jour une base de données ou déclencher un workflow. Cette approche introduit une boucle de feedback : l’IA observe le résultat de ses actions, analyse son efficacité et ajuste sa stratégie en conséquence, sans intervention humaine. C’est cette autonomie décisionnelle qui distingue fondamentalement l’IA agentique des systèmes génératifs traditionnels.
Qu’est-ce que la RAG agentique ?
La RAG agentique représente l’évolution naturelle de la génération augmentée de récupération classique. Là où la RAG traditionnelle suit un pipeline statique et séquentiel, la RAG agentique intègre des agents IA directement dans le processus de récupération et de génération. Ces agents ne se contentent pas d’exécuter une requête unique : ils décident eux-mêmes quelles sources consulter, dans quel ordre, et comment affiner leur recherche en fonction des résultats obtenus.
Définition de la RAG agentique
Concrètement, la RAG agentique est un système de génération augmentée piloté par des agents autonomes capables de planifier leurs actions. Contrairement à la RAG classique qui effectue une récupération unique et figée, les agents peuvent décomposer une requête complexe en sous-questions, sélectionner dynamiquement les outils et bases de données les plus pertinents, puis assembler les résultats pour produire une réponse cohérente. Cette approche transforme un pipeline linéaire en un système adaptatif qui raisonne, agit et s’auto-corrige.
Les 4 piliers de la RAG agentique
Pour bien comprendre ce qui distingue la RAG agentique, il faut identifier ses quatre piliers fondamentaux :
- Autonomie décisionnelle : les agents choisissent eux-mêmes leurs actions et leurs sources selon la requête reçue
- Recherche dynamique multi-sources : l’agent peut interroger plusieurs bases, API et outils en parallèle ou en séquence
- Génération augmentée par contexte : le système construit un contexte enrichi en agrégeant des données variées récupérées à la volée
- Boucle de feedback permanente : les résultats sont évalués par l’agent qui relance des recherches si la réponse est insuffisante
Cette architecture en quatre piliers permet à la RAG agentique de s’adapter à des cas d’usage complexes où la RAG classique montre ses limites. La capacité d’auto-correction est particulièrement précieuse dans les environnements où les données évoluent rapidement et où une simple récupération ponctuelle ne suffit plus.
Cette capacité d’itération et d’adaptation rappelle la manière dont on soigne le tendon d’Achille en course à pied, où un protocole progressif et personnalisé est essentiel.